monte-carlo-policy-gradient
monte-carlo 근사 방식으로 NN으로 행동에 대한 확률을 학습하여, policy-based로 문제를 해결하는 방법.
policy-based RL
기존의 Deep-SARSA 방식은 상태가치 함수를 통해 Q-function값을 학습하는 방식인 value-based RL 이었다면, policy-gradient는 NN에서 Q-function의 값이 아닌 policy(각 action에 대한 확률)을 바로 predict하기 때문에, policy-based RL 이라고 불린다.
따라서 기존의 Deep-SARSA 방정식은 아래와 같았지만,
policy-based RL은 model을 상태에 따른 policy를 표현한다고 해석하며, 아래와 같이 표현한다.
이때 상태가치 함수로 해석한 방법은, 초기 상태에서의 상태가치 함수의 값은 해당된 episode의 policy 값과 같기 때문에 이와 같이 해석할 수 있다.
그래서, policy-gradient RL의 목표는 이다. 그런데 목표를 max로 잡다 보니, gradient 입장에서는 경사 하강법(gradient descent)가 아닌 경사 상승법(gradient ascent)로 해석을 해야 한다.
어쨋든 각 시행에 대해 기존 Deep-SARSA에서의 step을 표현하던 를 learning_rate라고 해석하여, 다음과 같이 표현할 수 있다.
상태가치 함수를 에 대해 미분하는 과정은 아래에 유도하겠다. 이는 Richard Sutton - Policy Gradient Theorem을 기반으로 유도했다.
는 어떤 상태 s에 대해 Agent가 있을 확률을 의미한다. 상태 분포라고도 불리며, 모든 상태에 대해서 Agent가 있을 확률이 불균형 하니, 반영시켰다. 이때 확률은 경우의 수를 기반으로 하는 확률로 계산한다.
이때 는 어떤 상태 s에 agent가 있을 때, 행동 a을 할 조건부 확률인 결합확률을 뜻하고, 모든 s 상태에 따라 모든 a 행동의 확률을 합하므로, 이는 결합확률들의 합이 1이므로, 의 기댓값(E)으로도 생각할 수 있다. 따라서 아래의 식으로 유도된다.
그런데 한가지 문제점이 있다. 우리가 사용할 방식은 policy-based RL으로써, policy의 값만 알기 때문에 를 알 수 없다. 따라서, 이를 다른 변수로 치환해야 하는데, 대표적으로 로 치환한 알고리즘을 REINFORCE Algorithm(monte-carlo-policy-gradient)이라고 말한다.
REINFORCE Alogrithm
이 알고리즘은 아래의 식을 사용하며, 코드로 구현시에 추가적인 해석이 필요하다.
우선 NN을 학습시키기 위해 loss를 정의해야 하는데 같은 경우 에 귀속되어 있는 변수가 아니기 때문에, 에 같이 묶여도 상관없다. 그래서 아래로 정리하면 loss를 정의할 수 있다.
이는 Cross-Entropy Loss와 구조가 매우 흡사한데, Cross-Entropy같은 경우 이고, 가 1에 가까울 수록, loss가 작아진다. 그래서 이를 통해 이며, 일때 가 최대여야 하며, 그때의 가 1과 가까워야 한다는 목표를 가질 수 있다. 또한 gradient descent를 하기 위해 식에 조금 변형을 가해주면 코드로 구현해야 할 식을 구할 수 있다!
Environment
NN 의 환경은 Deep-SARSA와 동일하게 구성했다.
- Agent의 도착위치에 대한 상대 위치
- 도착지점 라벨
- Agent의 장애물에 대한 상대 위치
- 장애물 라벨
- 장애물 속도
현재 env에서 장애물을 3개로 구상하였기 때문에, (3,4,5) 에 대한 input은 3배를 해주어, 총 input_size는 15개로 인지하면 된다.
Code
1. init
lr, discount_factor, model, optim, append_lists
1-1. discount_factor
할인율로써, 벨만 방정식에서 부분이다. MDP(Markov Decision Process) 에서 보상 획득 시간을 구별하기 위해 넣은 개념이다.
1-2. append_lists
monte-carlo 방식이므로, 마지막에 불러오면서 를 업데이트 해주기 위해, state/action/reward를 배열에 저장했다.
2. discount_rewards
episode가 끝난 후, rewards를 통해 초기 상태의 반환값을 계산하는 함수이다. 이때 reversed를 쓴 이유는, 부터 계산 시에, 를 찍고 다시 역으로 내려와 값에 대해 업데이트가 진행되어야 하지만, 거꾸로 부터 계산한다면, 으로 계산이 간편해 지기 때문이다.
3. model
fully-connect layer로 node 30개씩 2 layer로 구현하였다. 마지막 output은 action의 확률을 판단해야 하니, action_size로 출력하도록 하였고, softmax 함수를 통해 합이 1이 되도록 했다. 나머지의 레이어에 활성함수는 각각 relu로 구현하였다.
4. optimizer
Adam을 사용하였다. 추후 SGD, Momentum, Adagrad 등을 episode에 따른 성능 비교로 지표를 뽑아보겠다.
결과
Train
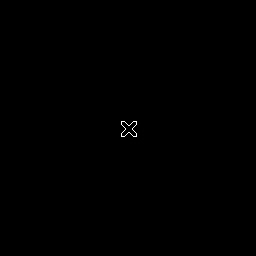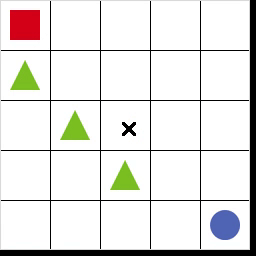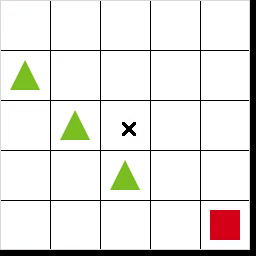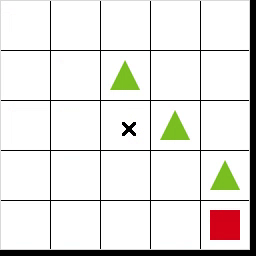
예상한대로, 맨 처음에는 초기값으로 움직이면서 마지막 부분에서 target으로 이동하여, episode를 끝내어 저장된 state/action/reward로 가중치를 업데이트 했다. 하지만 오른쪽 훈련을 보면, 초기값의 policy에 의존하다 보니, 높은 확률로 loop의 경로로 계속 이동하여, target 위치로 도달하지 못하는 모습이다. 이는 monte-carlo의 episode가 끝나야지 학습을 하는 고질적인 문제를 보여주는 사례이다.
이를 해결하기 위해 episode에 이동에 제한을 걸어놓는 등의 방법을 써볼 수 있을 것 같다. 실제로 10분 틀어놨는데 저 지경이였으니까..
Test
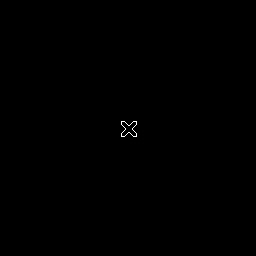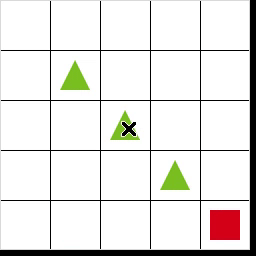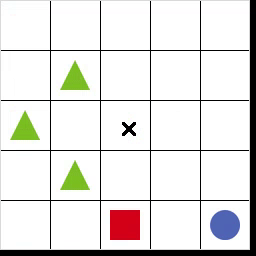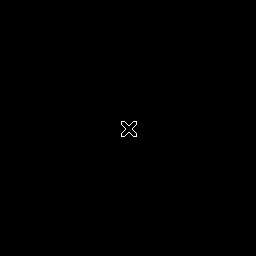
학습한 weight대로 잘 움직이며, episode를 100번 정도 학습하여, 온전치는 못하지만 대부분 score 10(최대치)를 잘 달성하는 모습니다. episode를 더 늘리면 더욱 더 완벽한 움직임이 될 것이다.
Graph
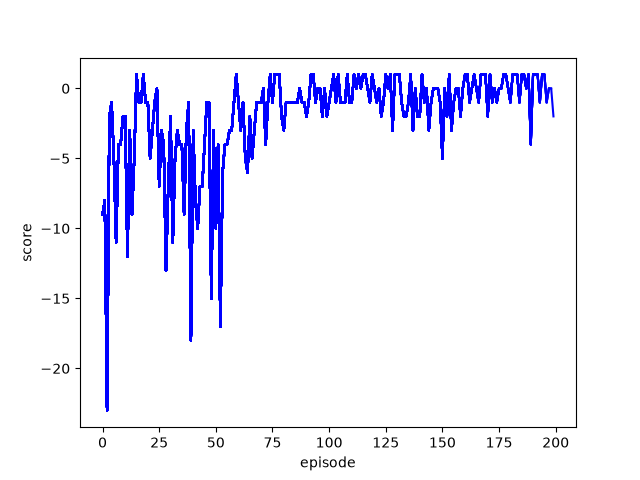
위 사진과 같이 학습이 진행되었고, episode를 끝내야 학습하는 방식 때문에, Deep-SARSA보다 학습이 느린 것을 볼 수 있다. 하지만, Deep-SARSA와는 달리 policy-based RL다 보니, 실제로 활용하기에는 더 적합한 방법같다.
댓글