deep-sarsa
Dynamic Programming의 차원의 저주와 계산 복잡도 문제를 해결하기 위해, SARSA의 시간차 제어를 NN을 통해 구현한 것.
SARSA (Temporal-difference Control)
기존에 상태가치 함수 를 통해 Policy를 iteration을 통해 구했던 방법에서 monte-carlo prediction의 환경을 모두 인지하고 있어야 하는 문제점으로 인해, Q-function(큐함수)를 기반으로 학습하는 방법.
이며, 매개변수가 이 들어가, 흔히 SARSA라고 칭한다.
이때 위의 식의 틀은 monte-carlo prediction을 기반으로 하고 있는데, 상태가치 함수는 반환값들의 평균이다라는 것을 기반으로 한 식에서 나왔다.
이를 풀어쓰면 step-size로 해석하여, monte-carlo predict 방정식이 나오지만, 현 Deep-SARSA는 Q함수를 기반으로 해석하기 때문에, 이상의 내용은 생략하겠다.
Environment
위의 SARSA 방식의 DP의 한계로 인해 모델을 NN을 통해 구현하였다. 그리하여, input으로 넣는 정보(MDP)는 아래와 같이 구상하였다.
- Agent의 도착위치에 대한 상대 위치
- 도착지점 라벨
- Agent의 장애물에 대한 상대 위치
- 장애물 라벨
- 장애물 속도
현재 env에서 장애물을 3개로 구상하였기 때문에, (3,4,5) 에 대한 input은 3배를 해주어, 총 input_size는 15개로 인지하면 된다.
장애물 개수 또한, training중에 인지해야 하는 정보라고 한다면, layer를 하나 더 늘려, 해당 layer의 node 하나하나를 장애물이라 대입 해볼 것 같다.
그리고 NN이다 보니, backpropagation을 위한 loss가 필요하다. 따라서 MSE를 토대로 loss를 정의하였고, 위에 SARSA의 Q-function 식에서 loss를 정의한 부분은 아래 식과 같다.
이렇게 행동을 하였을 때, 받는 보상과 Next_State에서 취할 action에 대한 가치는 현재 상태의 action에 대한 가치함수가 목표로 삼아야 할 값이고, 이에 대한 오차를 loss로 해석해도 될 것 같다.
아직 NN으로 구현하지 못한 Q-Learning 같은 경우 Off-policy 방식으로 위의 식에서 을 MAX값으로 처리하지 못하여 생기는 loop 문제를 해결 할 수 있다.
Code
1. init
epsilon, epsilon_decay, epsilon_min, lr, discount_factor, model, optim
1-1. Epsilon
epsilon-policy 를 토대로, 확률에 따라 행해야 할 action이 아닌 랜덤한 action을 취하도록 하였다. 이를 사용하여, 최적의 해를 찾기 위해 환경을 모두 지각하여야 하는 문제를 해결할 수 있다.
또한 epsilon_decay 변수를 통해, 변동성 감쇠를 주어, episode가 진행될 수록 정책에 의존하여 움직이도록 설정하였다.
1-2. discount_factor
할인율로써, 벨만 방정식에서 부분이다. MDP(Markov Decision Process) 에서 보상 획득 시간을 구별하기 위해 넣은 개념이다.
2. model
fully-connect layer로 node 30개씩 2 layer로 구현하였다. 마지막 output은 Q-function 의 값을 판단해야 하니, action_size로 출력하도록 하였고, 각각의 activation-function은 relu로 구현하였다. 이때 각 action에 대한 policy를 출력하는 것이 아닌, Q-function의 값을 최적의 Q-function값으로 근사시키기 위한 모델인 것을 참고해야 한다.
3. optimizer
Adam을 사용하였다. 추후 SGD, Momentum, Adagrad 등을 episode에 따른 성능 비교로 지표를 뽑아보겠다.
결과
Train
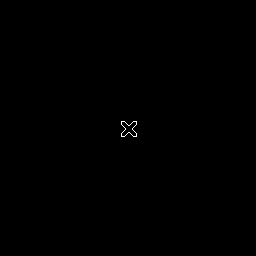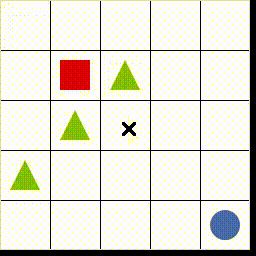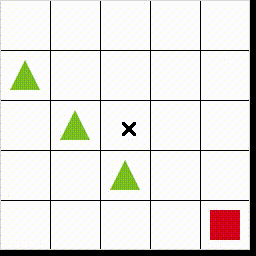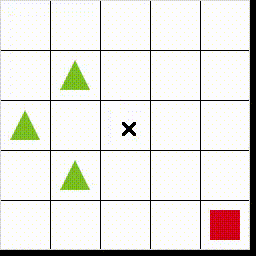
예상한대로, 맨 처음에는 epsilon = 1이므로 완전 랜덤한 상태로 움직이지만, 마지막 부분에서 target으로 이동하여, episode를 끝내어 weight를 업데이트 했다면, 다음에 그 위치로 이동했을때, policy를 토대로 바로 끝내버리는 모습을 볼 수 있다.
Test
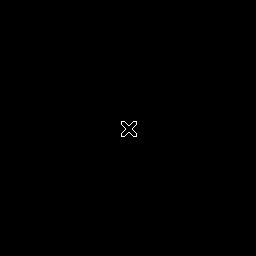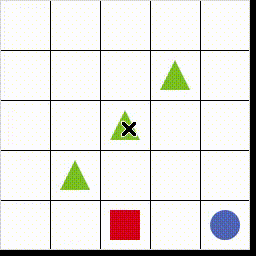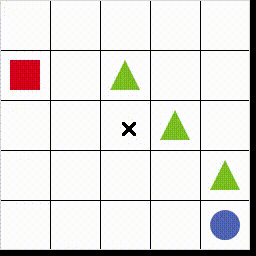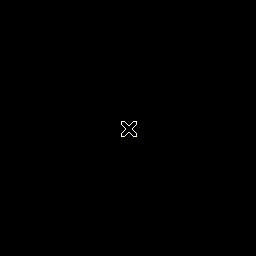
학습한 weight대로 잘 움직이며, episode 중간에 epsilon으로 인해 오른쪽으로 움직였지만, 최적의 policy대로 최소한의 움직임으로 도착하였다.
추가학습
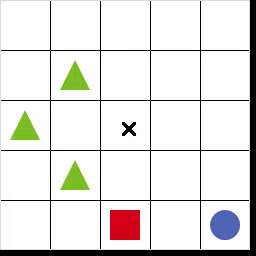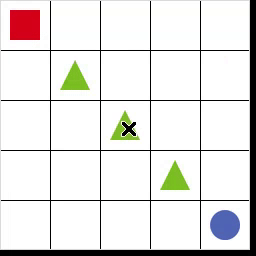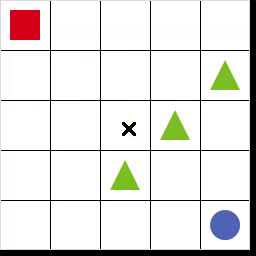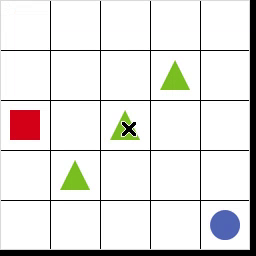
decay를 0.1로 설정하여, train 해보았다. 예상했던 것과 같이 환경 탐색의 경우의 수가 적어지고, 한번 지나가서 업데이트 된 Q-function의 값대로 움직이는 것을 볼 수 있다.
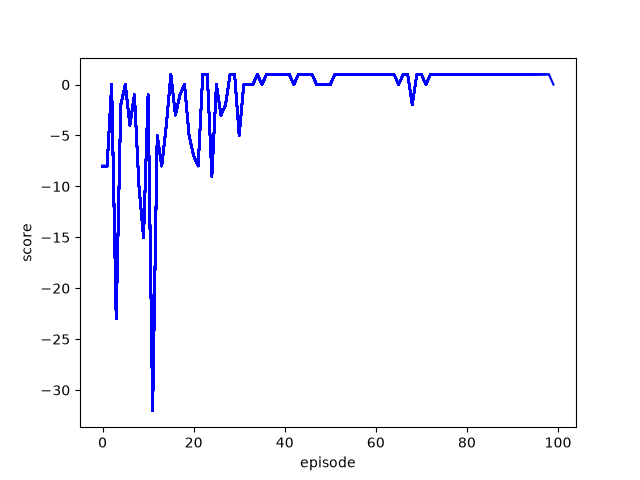
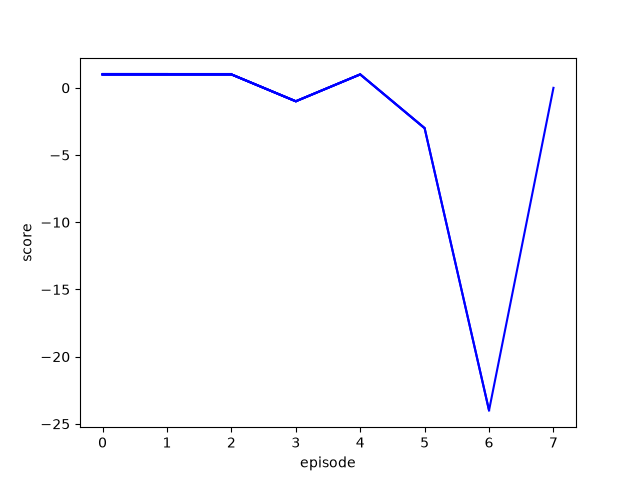
위 사진과 같이 확실히 왼쪽( decay = 0.99 )의 경우는 여러 Score를 뽑아내는 것으로 보아, 탐색을 원활히 잘 한다고 판단할 수 있는 반면, 오른쪽( decay = 0.01 )의 경우는 한번 지나간 정책대로 움직이며, 극히 드문 경우로 새로운 경로를 탐색하는 것을 볼 수 있다. 또한 loop로 인해 각 episode마다의 걸리는 시간이 엄청나게 오래걸리는 것을 알 수 있다.
댓글